 Cloud & AI Infrastructure
 Cloud & Cyber Security Expo
 Big Data & AI World
 Data Centre World
Insights
So betreiben Sie KI-Infrastruktur in großem Maßstab
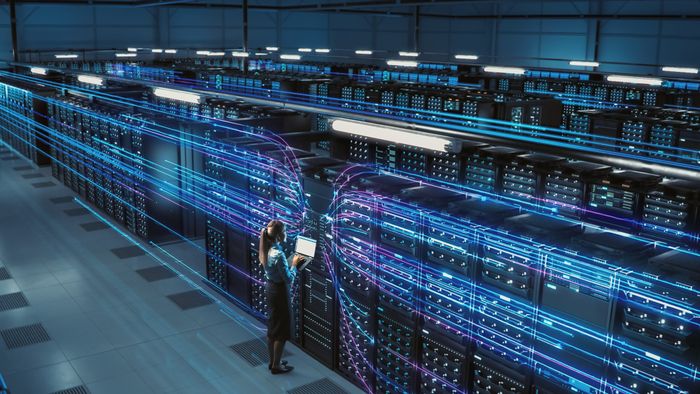
Der Betrieb einer KI-Infrastruktur in großem Maßstab stellt ebenso sehr eine Herausforderung für das Rechenzentrums operations wie für die Software dar. Sobald Pilotprojekte zu Produktionsdiensten werden, sind Chips und Code auf eine physische Umgebung angewiesen, die auch unter Last verfügbar bleiben muss. Die Teams müssen diese Umgebung in Betrieb nehmen, überwachen, warten und wiederherstellen, ohne den Geschäftsbetrieb zu beeinträchtigen.
Der Druck nimmt zu. Die Internationale Energieagentur prognostiziert, dass die Stromerzeugung zur Versorgung von Rechenzentren von etwa 460 TWh im Jahr 2024 auf über 1.000 TWh im Jahr 2030 steigen wird. Der Netzzugang und die effiziente Nutzung von Strom werden daher zu alltäglichen betrieblichen Herausforderungen.
Warum sich die Infrastruktur von KI-Rechenzentren von anderen unterscheidet
Ein herkömmliches Unternehmensrechenzentrum betreibt eine breite Palette von Geschäftssystemen, in der Regel auf CPU-basierten Servern. Ein KI-Rechenzentrum bündelt GPUs oder andere Beschleuniger in eng vernetzten Systemen, die große Datensätze mit hoher Geschwindigkeit austauschen.
Diese Konzentration verändert das Betriebsumfeld. Laut dem Uptime Institute liegt die Leistung der überwiegenden Mehrheit der Racks weiterhin unter 10 kW. Aktuelle KI-Systeme mit hoher Dichte können 40 kW überschreiten, und Implementierungen der nächsten Generation können die 100-kW-Marke überschreiten. Sie benötigen mehr Strom und schnellere Netzwerkverbindungen, erzeugen dabei jedoch auf kleinem Raum deutlich mehr Wärme. Ein einziger Ausfall in den Bereichen Kühlung, Netzwerk oder Stromversorgung kann den Betrieb einer kostspieligen Gruppe miteinander vernetzter Maschinen unterbrechen.
Nicht jeder KI-Einsatz erreicht diese Auslastungsgrade. Das Training großer Modelle stellt in der Regel die höchsten Anforderungen an die Infrastruktur. Die Inferenz in Unternehmen ist oft weniger umfangreich; daher sollten Betreiber die Anlage an die jeweilige Arbeitslast anpassen, anstatt davon auszugehen, dass jeder KI-Dienst die gleiche Auslegung benötigt.
Woraus besteht der KI-Infrastruktur-Stack?
Die GPU-Infrastruktur geht über den Beschleuniger selbst hinaus. Rechenknoten kombinieren GPUs mit CPUs, Speicher mit hoher Bandbreite und schnellen Verbindungen. Der Speicher hält die Daten in der Nähe des Clusters, während die Software Aufträge plant, Kapazitäten gemeinsam nutzt und die Leistung überwacht.
Die darunter liegende Infrastruktur muss eine stabile Stromversorgung gewährleisten, Wärme abführen und die Geräte schützen. Die DGX BasePOD-Referenzarchitektur von NVIDIA veranschaulicht diese Abhängigkeit: Ihre Rechenknoten sind auf separate Netzwerke für Rechenleistung, Speicher und Verwaltung sowie auf validierte Speicher- und Cluster-Software angewiesen. Der Kauf von GPUs vor der Überprüfung der unterstützenden Infrastruktur kann dazu führen, dass kostspielige Hardware nicht voll ausgelastet wird.
Leistungsdichte und Flüssigkeitskühlung
Die Kühlung macht diesen Wandel sichtbar. Das Uptime Institute beziffert den Kühlbedarf bei Perimeter-Luftkühlung auf etwa 20 bis 25 kW pro Rack und bei direkt gekoppelten Luftsystemen auf bis zu 50 kW. Oberhalb dieser Werte wird in der Regel die direkte Flüssigkeitskühlung zum bevorzugten Ansatz. Bei Direct-to-Chip-Systemen wird die Flüssigkeit durch Kühlplatten geleitet, die an Komponenten wie CPUs und GPUs angebracht sind. Beim Immersionskühlung werden die Geräte in eine dielektrische Flüssigkeit getaucht; laut Uptime wird diese Methode nach wie vor seltener eingesetzt und hat sich für KI-Workloads noch nicht flächendeckend durchgesetzt.
Systeme in der Praxis zeigen, wie schnell sich die Anforderungen ändern. Googles „Ironwood TPU Pod“ mit 9.216 Chips ist flüssigkeitsgekühlt und hat eine Leistung von fast 10 MW. Auch Microsoft hat in einem Produktionsrechenzentrum eine zweiphasige Tauchkühlung eingesetzt. Diese Beispiele basieren auf unterschiedlichen Konstruktionen, da die Kühlung auf die Dichte, die Hardware und das Betriebsmodell abgestimmt sein muss.
Das Lawrence Berkeley National Laboratory (LBNL) berichtet, dass eine „Direct-to-Chip“-Kühlung den kühlungsbedingten Energieverbrauch in Systemen mit hoher Wärmelast senken und dazu beitragen kann, eine thermische Drosselung der Prozessoren zu vermeiden. Der Nachteil besteht darin, dass mehr Geräte betrieben werden müssen, darunter Pumpen und Kühlmittelverteilungsanlagen, sowie Maßnahmen zur Leckageerkennung und zur Kontrolle der Wasserqualität. Für die Restwärme ist möglicherweise weiterhin eine Luftkühlung erforderlich.
Wie Teams KI-Infrastruktur beschaffen und überwachen
Die Verantwortung kann bei einem Infrastruktur director, einem Rechenzentrums manager oder einem Plattform-Engineering-Leiter liegen, der mit der Beschaffungsabteilung und der Gebäudeverwaltung zusammenarbeitet. Der Einkäufer benötigt zunächst ein realistisches Arbeitslastprofil. Ist der Dienst für Trainingszwecke oder für Inferenzberechnungen vorgesehen? Wie intensiv wird er genutzt, wo müssen die Daten verbleiben und wie schnell könnte der Bedarf steigen? Die Teams müssen anschließend die verfügbare Stromleistung, die unterstützte Rack-Dichte, die Kompatibilität der Kühlung, den Erweiterungsraum sowie den Liefertermin für einen eventuellen Netzanschluss bestätigen. Bei der Inbetriebnahme sollte diese gesamte Kette unter realistischer Last getestet werden.
Nach der Inbetriebnahme sollte die Überwachung sowohl Anlagen- als auch IT-Daten einbeziehen. Die Betreiber müssen neben der GPU-Auslastung, der Netzwerkauslastung, der Speicherleistung und den Auftragsfehlern auch die Leistungsaufnahme und die thermischen Bedingungen im Blick haben. Das LBNL weist darauf hin, dass KI-Workloads den Strombedarf schnell verändern können, weshalb Echtzeitmesswerte und sinnvolle Alarmschwellen unerlässlich sind. Überwachungstools sind nur dann hilfreich, wenn die Teams zudem über klare Eskalationswege, Ersatzteile und einstudierte Wiederherstellungsverfahren verfügen.
Wie Colocation Rechenzentren unterstützt Operations
Unter Colocation versteht man die Unterbringung der eigenen Hardware eines Unternehmens in einem Rechenzentrum eines Drittanbieters. Wie Equinix erläutert, stellt der Betreiber die Räumlichkeiten und die gemeinsam genutzte Infrastruktur zur Verfügung; der Kunde behält die Kontrolle über seine Server. Dadurch lassen sich der Zeit- und Kapitalaufwand für den Bau einer eigenen Anlage vermeiden. Die Bezeichnung „AI-ready“ ist jedoch kein Beweis dafür, dass ein Standort für die jeweilige Arbeitslast geeignet ist.
Käufer sollten Nachweise über die tatsächlich bereitgestellte Leistung einholen und nicht nur die Nennleistung. Sie sollten zudem die Kühlung bei der geplanten Rack-Dichte, den Erweiterungsmöglichkeiten, den Zugriff auf die Überwachung sowie den Umfang des „Remote-Hands“-Supports überprüfen. Die Kühlungsrichtlinien des Uptime Institute warnen davor, dass eine direkte Flüssigkeitskühlung die Grenzen der Service-Level-Vereinbarungen zwischen den Betreiberteams der Einrichtung und den Mietern verwischen kann. Die Zuständigkeiten für Kühlkreisläufe, Leckagealarme, Wartung und Notabschaltungen sollten daher vor der Installation vereinbart werden.
Die Ausfallsicherheit eines Rechenzentrums hängt von der gesamten Betriebsumgebung ab. Ein aussagekräftiger Maßstab ist, wie viel Rechenleistung das Unternehmen innerhalb seiner Kosten-, Strom- und Kühlungsgrenzen konsistent bereitstellen kann. Teams, die die Betreiber des Rechenzentrums frühzeitig einbeziehen und Ausfälle anhand eines gemeinsamen Kapazitätsplans simulieren, sind besser in der Lage, Investitionen in KI in einen zuverlässigen Unternehmensdienst umzuwandeln.
Forschungsquellen
• Internationale Energieagentur Energieversorgung für KI
• Uptime Institute Intelligence: KI sowie Kühlverfahren und -kapazitäten
• Lawrence Berkeley National Laboratory Rechenhardware und Benchmarking
• NVIDIA Enterprise-KI-Referenzarchitektur für DGX BasePOD
• Google Ironwood TPU für das Zeitalter der Inferenz
• Microsoft Zur Kühlung der Server in Rechenzentren setzt Microsoft auf siedende Flüssigkeit
• Uptime Institute Intelligence: DCIM-Beschaffungsleitfaden 2026
• ASHRAE: Entstehung und Verbreitung der Flüssigkeitskühlung in Mainstream-Rechenzentren